Saber cómo configurar robots.txt para SEO técnico es una de las habilidades más críticas para cualquier administrador web o especialista en posicionamiento. Este archivo, aunque sencillo en apariencia, actúa como el primer punto de contacto entre tu servidor y los rastreadores de los motores de búsqueda, determinando qué partes de tu sitio deben ser exploradas y cuáles deben permanecer ocultas.
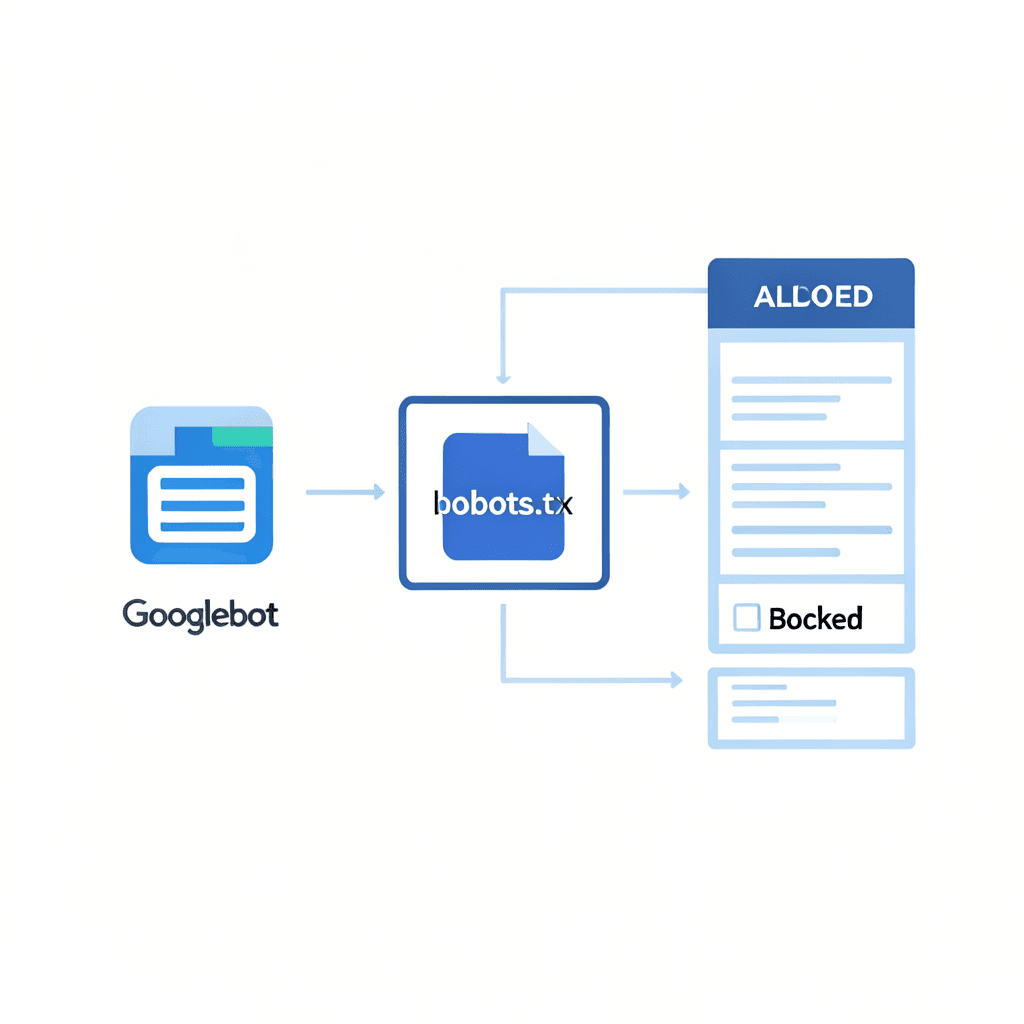
Cuando un bot como Googlebot llega a tu dominio, lo primero que busca es el archivo robots.txt para entender las reglas de juego. Si este archivo está mal configurado, podrías estar bloqueando accidentalmente contenido vital para tu conversión o, peor aún, permitiendo que el bot desperdicie recursos en páginas irrelevantes, afectando directamente tu visibilidad en los resultados de búsqueda.
En esta guía exhaustiva, aprenderás no solo la sintaxis básica, sino también estrategias avanzadas para gestionar el presupuesto de rastreo. Para lograr un rendimiento óptimo, es fundamental contar con un hosting optimizado que soporte la carga de los bots sin ralentizar la experiencia del usuario final.
¿Qué es el archivo robots.txt y para qué sirve?
El archivo robots.txt es un archivo de texto plano que se coloca en el directorio raíz de un sitio web. Su función principal es proporcionar instrucciones a los rastreadores de los motores de búsqueda sobre cuáles URLs y componentes del sitio no deben ser rastreados. Es importante entender que el robots.txt es una sugerencia, no una directiva obligatoria, aunque la mayoría de los buscadores modernos la respetan estrictamente.
Desde una perspectiva de SEO técnico, este archivo es la herramienta principal para gestionar el presupuesto de rastreo (crawl budget). El presupuesto de rastreo es la cantidad de páginas que Google decide rastrear en tu sitio durante un periodo determinado. Si tienes miles de páginas irrelevantes, el bot podría agotarse antes de llegar a tus páginas de producto o servicios más importantes.
Además, el robots.txt permite indicar la ubicación del Sitemap XML, facilitando que los buscadores encuentren todas tus URLs indexables de manera eficiente. Sin un archivo bien estructurado, el proceso de indexación puede volverse errático, provocando que contenido antiguo o duplicado aparezca en los resultados de búsqueda.
Para comprender mejor su impacto, veamos los elementos básicos que componen este archivo:
- User-agent: Define a qué bot se dirigen las instrucciones (ej. Googlebot, Bingbot).
- Disallow: Indica las rutas que el bot no debe rastrear.
- Allow: Permite el rastreo de una subcarpeta dentro de una ruta bloqueada.
- Sitemap: Proporciona la URL completa hacia el mapa del sitio.
Cómo configurar robots.txt para SEO técnico paso a paso
El proceso de configuración comienza con la creación de un archivo simple llamado ‘robots.txt’ utilizando cualquier editor de texto. Es vital que el nombre sea exactamente ese, en minúsculas, ya que los servidores Linux distinguen entre mayúsculas y minúsculas. Una vez creado, debe subirse a la carpeta raíz de tu servidor (ej. public_html/robots.txt).
El primer paso es definir el User-agent. Si quieres que las reglas se apliquen a todos los buscadores, debes usar el asterisco (User-agent: *). A partir de ahí, comienza la definición de las rutas. Por ejemplo, si tienes un panel de administración en /admin/, debes añadir Disallow: /admin/ para evitar que el bot intente entrar en áreas privadas.
Un error común es bloquear archivos CSS o JS. Antiguamente se hacía para ahorrar recursos, pero hoy en día Google necesita renderizar la página como lo hace un usuario para evaluar la experiencia de usuario (Core Web Vitals). Bloquear estos recursos puede penalizar tu posicionamiento porque el bot verá una página ‘rota’ o sin diseño.
Para implementar la configuración correctamente, sigue este flujo de trabajo:
- Analiza tu estructura de URLs y detecta secciones no útiles para el usuario final (filtros, búsquedas internas, carritos).
- Redacta las directivas de bloqueo utilizando la sintaxis correcta de
Disallow. - Añade la ruta de tu Sitemap XML al final del archivo para mejorar la indexación.
- Sube el archivo al servidor y verifica que sea accesible vía
tudominio.com/robots.txt. - Utiliza la herramienta de prueba de robots.txt de Google Search Console para validar que no hay errores.
Recuerda que el robots.txt evita el rastreo, pero no garantiza que la página no se indexe si existen enlaces externos apuntando a ella. Para evitar la indexación total, debes usar la etiqueta meta ‘noindex’.
Gestión del presupuesto de rastreo y optimización
El presupuesto de rastreo es un recurso finito. En sitios web pequeños, esto no suele ser un problema, pero en e-commerce con miles de variaciones de productos, es crítico. Si el bot gasta tiempo rastreando parámetros de filtrado (como ?color=rojo&talla=xl), podría ignorar nuevas publicaciones en tu blog corporativo o actualizaciones de precios.
Para optimizar este presupuesto, debemos identificar las ‘trampas de rastreo’ (crawl traps). Estas son URLs generadas dinámicamente que crean un bucle infinito de contenido similar. Bloquear estas rutas en el robots.txt es la forma más rápida de liberar recursos para que Google se centre en el contenido que realmente convierte.
Otra estrategia avanzada es el uso de directivas específicas para bots secundarios. Por ejemplo, puedes permitir que Googlebot rastree todo, pero restringir a bots de herramientas de SEO agresivas que puedan saturar tu servidor y afectar la velocidad de carga.
A continuación, comparamos el impacto de diferentes configuraciones en el presupuesto de rastreo:
| Configuración | Impacto en el Bot | Resultado SEO |
|---|---|---|
| Sin robots.txt | Rastreo indiscriminado | Riesgo de indexar basura |
| Bloqueo de /admin/ y /search/ | Rastreo enfocado | Mejor eficiencia de indexación |
| Bloqueo de CSS/JS | Rastreo incompleto | Posible penalización por UX |
La clave es el equilibrio: no bloquees demasiado para no ocultar contenido valioso, ni bloquees muy poco para no desperdiciar el tiempo del bot.
Errores comunes al configurar robots.txt para SEO técnico
Uno de los errores más catastróficos es dejar la directiva Disallow: / en un sitio que ya está en producción. Esta línea le dice a todos los buscadores que no rastreen absolutamente nada del sitio. A menudo ocurre cuando los desarrolladores configuran el entorno de pruebas (staging) y olvidan cambiarlo al migrar a producción.
Otro fallo frecuente es confundir el robots.txt con una herramienta de seguridad. El archivo robots.txt es público; cualquier persona puede escribir tudominio.com/robots.txt y ver exactamente qué carpetas estás intentando ocultar. Nunca pongas rutas a carpetas secretas o sensibles aquí; usa contraseñas o autenticación a nivel de servidor.
Asimismo, el uso excesivo de comodines (wildcards) puede llevar a bloqueos accidentales. El uso del símbolo * y $ es potente pero peligroso si no se domina la sintaxis. Un error en un solo carácter puede dejar fuera de Google una categoría entera de productos.
Para evitar estos fallos, considera estas recomendaciones:
- Verifica siempre el archivo después de cada actualización del sitio.
- No uses el robots.txt para gestionar contenido duplicado; usa etiquetas canónicas.
- Evita rutas demasiado largas o complejas que puedan confundir al bot.
- Asegúrate de que el archivo esté codificado en UTF-8 sin BOM.
- No bloquees el acceso a los archivos de optimización de imágenes.
La validación constante es la única forma de garantizar que tu configuración no esté dañando tu visibilidad orgánica.
Diferencias entre robots.txt y la etiqueta Meta Noindex
Es fundamental distinguir entre ‘rastrear’ (crawl) e ‘indexar’ (index). El robots.txt controla el rastreo. Si bloqueas una URL, el bot no entrará en ella. Sin embargo, si esa URL recibe enlaces desde otros sitios, Google puede decidir indexarla basándose en las señales externas, aunque no conozca el contenido de la página.
Por otro lado, la etiqueta meta name='robots' content='noindex' controla la indexación. Para que esta etiqueta funcione, el bot debe poder rastrear la página. Si bloqueas la página en el robots.txt y además pones un noindex, el bot nunca verá la etiqueta noindex porque tiene prohibido entrar, y la página podría seguir apareciendo en los resultados.
Por lo tanto, si tu objetivo es que una página desaparezca totalmente de Google, debes permitir el rastreo en el robots.txt y aplicar el noindex en el HTML. Si solo quieres ahorrar presupuesto de rastreo en páginas que no te importa que estén indexadas (pero que no aportan valor), usa el robots.txt.
Para optimizar la entrega de estos recursos y asegurar que el bot reciba las respuestas rápidamente, es recomendable implementar un CDN configurado correctamente, lo que reduce la latencia en la respuesta del servidor.
Resumen de uso según el objetivo:
- Objetivo: Ahorrar Crawl Budget $
ightarrow$ Usar robots.txt (Disallow). - Objetivo: Eliminar de Google $
ightarrow$ Usar Meta Noindex (Permitir rastreo). - Objetivo: Evitar contenido duplicado $
ightarrow$ Usar Rel=Canonical. - Objetivo: Ocultar archivos sensibles $
ightarrow$ Usar .htaccess o autenticación. - Objetivo: Guiar al bot al Sitemap $
ightarrow$ Usar robots.txt (Sitemap: URL).
Directivas avanzadas y sintaxis para expertos
Para quienes buscan un control total, existen directivas más allá del simple Allow y Disallow. El uso de comodines permite crear reglas dinámicas. Por ejemplo, Disallow: /*? bloquea todas las URLs que contienen un signo de interrogación, lo cual es ideal para eliminar el rastreo de parámetros de búsqueda y filtros en tiendas online.
El símbolo $ se utiliza para indicar el final de una URL. Si quieres bloquear una página específica pero no cualquier página que empiece por ese nombre, el signo de dólar es tu mejor aliado. Por ejemplo, Disallow: /privado$ bloqueará exactamente esa URL, pero permitirá el acceso a /privado/documento.pdf.
Además, es posible crear reglas específicas para diferentes bots. Puedes ser permisivo con Googlebot pero restrictivo con bots de redes sociales o bots de indexación de competidores, optimizando así la carga de tu servidor y protegiendo tu propiedad intelectual.
Ejemplos de sintaxis avanzada:
User-agent: Googlebot$
ightarrow$ Reglas solo para Google.Disallow: /blog/*/autor/$
ightarrow$ Bloquea todas las páginas de autor dentro de cualquier categoría del blog.Allow: /blog/importante$
ightarrow$ Permite una URL específica dentro de una carpeta bloqueada.Disallow: /wp-admin/$
ightarrow$ Bloqueo estándar para el panel de WordPress.Sitemap: https://web.com/sitemap_index.xml$
ightarrow$ Declaración obligatoria del mapa del sitio.
Dominar estas expresiones regulares permite una gestión quirúrgica del SEO técnico, evitando errores masivos de indexación.
Herramientas para validar tu configuración de robots.txt
No basta con subir el archivo; es imperativo validar que las reglas se aplican como esperas. La herramienta más potente es el Probador de robots.txt de Google Search Console. Esta herramienta te permite simular una URL y ver exactamente qué directiva la está bloqueando o permitiendo, evitando que cometas errores que afecten tu tráfico orgánico.
Existen también validadores externos y plugins para CMS como WordPress (Yoast SEO o Rank Math) que permiten editar el archivo desde el panel de administración. Aunque son cómodos, siempre recomendamos verificar la salida final mediante el navegador para asegurar que no haya espacios en blanco o caracteres extraños al inicio del archivo.
Otro método efectivo es el uso de comandos de terminal como curl o wget para comprobar que el servidor devuelve un código de estado 200 OK al solicitar el archivo. Si el servidor devuelve un 404 o un 500, los bots asumirán que no hay restricciones, lo que podría ser contraproducente.
Lista de verificación final antes de publicar:
- ¿El archivo se llama exactamente ‘robots.txt’?
- ¿Está ubicado en la raíz del dominio?
- ¿He incluido la URL del Sitemap?
- ¿He evitado bloquear archivos CSS y JS?
- ¿He probado las URLs críticas en Search Console?
La validación técnica es el paso que separa a un principiante de un experto en SEO técnico.
Conclusión: El impacto real de un robots.txt optimizado
Configurar correctamente el archivo robots.txt es una pieza fundamental del rompecabezas del SEO técnico. Al gestionar eficientemente el presupuesto de rastreo y evitar la indexación de contenido irrelevante, permites que los motores de búsqueda valoren mejor las páginas que realmente generan valor para tu negocio, acelerando la indexación de nuevo contenido y mejorando la calidad general de tu presencia online.
A lo largo de esta guía, hemos visto que la simplicidad del archivo es engañosa; un solo error puede borrar tu sitio de los resultados de búsqueda, mientras que una configuración precisa puede potenciar tu rendimiento. La clave reside en la monitorización constante y en la alineación de este archivo con el resto de tu estrategia de indexación, incluyendo el uso de sitemaps y etiquetas canónicas.
Ahora que ya sabes cómo configurar robots.txt para SEO técnico, es momento de auditar tu sitio y optimizar cada directiva. No olvides que el SEO es un proceso continuo de mejora; revisa tus logs de servidor y las herramientas de Google para ajustar tus reglas a medida que tu sitio web crezca y evolucione.